

Voici pourquoi il te faut une infrastructure solide pour être prêt pour les agents en 2025
Avant que les Microsoft 365 Copilot Agents puissent apporter une réelle valeur, le socle doit être solide : des données propres, des autorisations correctes et une infrastructure fiable. Ce guide explique pourquoi la qualité des données décide du succès de l'IA, met en lumière des risques comme l'oversharing et les silos, et présente 10 étapes concrètes pour préparer ton environnement M365 aux agents de façon sécurisée, conforme et évolutive.

Prologue
Face à l'omniprésence de l'IA, les idées se multiplient, tout comme l'envie d'agir ou au moins d'expérimenter. Chez glueckkanja AG, nous accompagnons nos clients tout au long de ce processus. Nous développons et construisons bien sûr déjà des agents, mais dans 80 % de nos projets, l'essentiel du travail consiste à préparer les données et le tenant à la création d'agents. Avant de mettre Copilot en production dans ton organisation, il vaut la peine de jeter un regard critique sur ton infrastructure. Plusieurs aspects importants doivent être compris avant de déployer des agents IA à grande échelle, et c'est pourquoi je te guide dans cet article à travers les étapes essentielles et les différences entre les approches. À une époque où des assistants IA comme les Microsoft 365 Copilot Agents promettent de transformer le monde du travail, un principe s'impose avant tous les autres : une IA ne vaut que ce que vaut le système sur lequel elle repose.
Ce guide détaille comment préparer tes données et ton infrastructure pour les Copilot Agents, avec les pratiques clés pour SharePoint, Teams et la Power Platform.
Pourquoi ton infrastructure (et tes données) compte
Quand on utilise des agents IA, il faut comprendre qu'ils ne savent rien par eux-mêmes de notre organisation, de nos données ou de notre contexte opérationnel. Par défaut, un agent IA ne dispose que des connaissances issues de l'entraînement du Large Language Model (LLM). Pour étendre réellement ses capacités, il faut y intégrer méthodiquement différents composants : System Prompts, bases de connaissances, connecteurs, recherche web, accès à Microsoft Graph, recherche sémantique et d'autres outils encore. Ensemble, ces composants permettent aux agents de fournir des réponses et des actions plus précises et mieux adaptées au contexte, alignées sur les besoins et les données propres à l'organisation. Comme nous n'en sommes qu'au tout début de l'ère agentique, beaucoup d'entre nous commenceront par des agents simples qui puisent leurs informations dans des bibliothèques SharePoint Online existantes.
Pour nous, à l'IT, cela signifie qu'il faut prendre soin de nos données dans SharePoint Online plus que jamais.
SharePoint Online = connaissances = données, et données = clé
Mon message est clair : avant d'introduire des copilotes IA dans ton organisation, mets de l'ordre dans tes données. Les données qui alimentent tes Copilot Agents alimentent aussi Microsoft 365 Copilot lui-même.
Et ce n'est pas tout : Microsoft 365 Copilot accède aux mêmes données. Si ces données sont désordonnées, partagées trop largement ou mal protégées, l'IA peut faire remonter de façon inattendue des informations erronées ou sensibles. Imagine par exemple que tu interroges Copilot sur l'organisation de l'entreprise et que tu reçoives les détails d'un projet de réorganisation confidentiel que tu n'étais pas censé voir. Ce genre d'incident se produit lorsque des contenus font l'objet d'oversharing, c'est-à-dire qu'ils sont accessibles trop largement sur des plateformes comme SharePoint ou Teams. À noter : Copilot respecte toutes les autorisations existantes, ce type de situation ne peut donc se produire que si les autorisations sont mal configurées. À l'inverse, si les données sont cloisonnées en silos ou inaccessibles, les assistants IA perdent en utilité.
Copilot ne fait remonter que les données de l'organisation pour lesquelles l'utilisateur dispose au moins d'un droit de lecture.
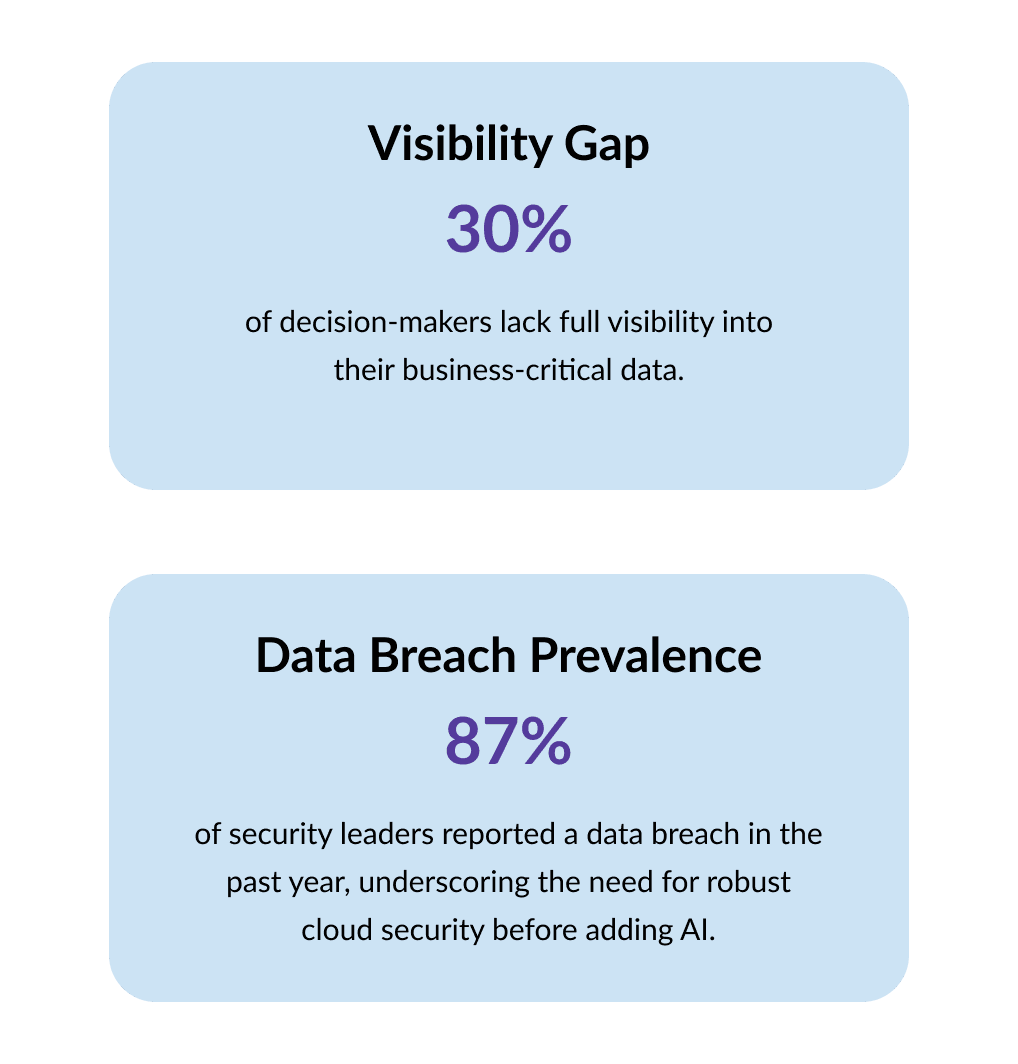
À retenir : l'IA en entreprise ne réussit que sur un socle de données solide. Un récent rapport de Microsoft désigne l'oversharing, les fuites de données et les usages non conformes comme les principaux défis à relever avant de déployer l'IA. Les organisations qui investissent dans la préparation de SharePoint Online et de leurs autres sources de données profiteront de Copilot en toute confiance, tandis que les autres s'exposent à des failles de sécurité ou à des résultats d'IA sans pertinence. Selon plusieurs études, environ un tiers des décideurs n'ont pas une visibilité complète sur leurs données critiques.
10 étapes pour améliorer dès maintenant ton infrastructure de données M365
Nous savons désormais que tes agents auront besoin de données. Lorsque nous intervenons sur ces projets chez glueckkanja, voici la liste en dix points que nous déroulons généralement du début à la fin avec nos clients.
Étape 1 : vérifier les paramètres de partage de base
Vérifie les paramètres à l'échelle du tenant qui pourraient conduire à de l'oversharing. Examine par exemple les règles de partage de liens par défaut (si « Anyone with the link » ou « People in your organization » est autorisé par défaut pour SharePoint/OneDrive), la possibilité pour les utilisateurs de créer des équipes Teams publiques par défaut, et l'ouverture éventuelle de ton environnement Power Platform sans aucune gouvernance. Des valeurs par défaut mal configurées à ce niveau sont une cause fréquente d'accès trop larges et involontaires.
Étape 2 : auditer les équipes Teams publiques
Passe en revue toutes les équipes Microsoft Teams marquées comme « Public ». Une équipe publique signifie que n'importe qui dans ton organisation peut la trouver et accéder à son contenu. Assure-toi que chaque équipe publique ne contient réellement que des contenus non sensibles, adaptés à une large diffusion. Si ce n'est pas le cas, passe-la en privé ou ajuste ses membres. (Il arrive facilement qu'une équipe soit créée en mode public puis oubliée, ce qui expose ses fichiers à l'ensemble des collaborateurs.)
Étape 3 : examiner les Graph Connectors
Vérifie si des Microsoft Graph Connectors sont configurés dans ton tenant pour importer des données tierces, par exemple depuis des systèmes de fichiers externes ou des wikis. Supprime ou sécurise tout connecteur qui indexe des données que tout le monde ne devrait pas voir. La raison : les contenus indexés via les Graph Connectors entrent dans ton index de recherche Microsoft Graph, ce qui signifie que Copilot peut potentiellement les utiliser pour répondre aux prompts. Seules des sources de données pertinentes et voulues doivent être connectées.
Étape 4 : générer un SharePoint Online Baseline Report
SPO présente plusieurs risques de voir des données indésirables apparaître dans les agents et dans Copilot. Plusieurs indicateurs clés sont à examiner :
- Héritage des autorisations rompu au niveau des dossiers
- Sites SharePoint publics
- Utilisation de « Everyone Except External Users » ou d'autres groupes dynamiques contenant tous les utilisateurs
- Liens de partage « Anyone »
- Liens de partage « Everyone in my org »
- Personnes indésirables dans les groupes Site Admins / Owners / Members / Visitors
Étape 5 : catégoriser et prioriser les risques
Reprends les constats des étapes 1 à 4 et classe-les par gravité. Identifie les sites ou fichiers qui contiennent les données les plus critiques pour l'activité ou les plus sensibles et qui présentent en même temps un risque d'exposition, puis traite-les en priorité. En ajoutant le contexte métier (un site contenant des données financières n'a pas le même poids qu'un site de modèles génériques), tu peux te concentrer d'abord sur les problèmes aux conséquences les plus lourdes.
Étape 6 : impliquer les propriétaires de sites dans les révisions d'accès
Pour chaque site SharePoint (ou équipe Teams) identifié comme risqué, demande au propriétaire du site de vérifier qui y a accès et si c'est justifié. Les propriétaires sont généralement les plus proches du contenu et repèrent vite ce genre de chose : « Tiens, pourquoi Everyone a-t-il un accès en lecture ici ? Ça ne devrait pas être le cas. » Mets en place un processus dans lequel les administrateurs de site certifient régulièrement les autorisations.
Étape 7 : mettre en place une surveillance continue
Mets en place un processus de surveillance continue pour détecter les nouveaux cas d'oversharing. Le contrôle de l'oversharing ne se règle pas une fois pour toutes : à mesure que de nouveaux sites, équipes et fichiers sont créés, il faut repérer les erreurs de configuration de manière proactive. Les rapports et les alertes de Microsoft Purview permettent par exemple de détecter les fichiers partagés en externe ou avec de très grands groupes, ou encore la création de nouvelles équipes publiques. Les outils Microsoft peuvent automatiser les alertes pour ces situations, sers-t'en pour maintenir un bon niveau de sécurité.
Étape 8 : appliquer des Sensitivity Labels et des stratégies DLP
Utilise les Sensitivity Labels de Microsoft Purview pour classifier les données (Confidential, Highly Confidential, etc.) et associe ces labels à des paramètres de protection. Un label « Confidential » peut par exemple chiffrer des fichiers ou empêcher leur partage externe. Configure également des stratégies de Data Loss Prevention (DLP) pour empêcher ou surveiller le partage excessif d'informations sensibles, par exemple en bloquant l'envoi par e-mail d'une liste de numéros de sécurité sociale de clients. Ces outils n'évitent pas seulement les fuites accidentelles au quotidien, ils fonctionnent aussi avec Copilot : si Copilot tente d'accéder à des contenus labellisés ou de les restituer d'une manière non prévue, la DLP peut intervenir. Copilot reporte en outre lui-même le label du document sur ses réponses, comme nous le verrons plus loin.
Étape 9 : mettre en place la gouvernance de la Power Platform
Étends ta surveillance à la Power Platform (Power Apps, Power Automate, etc.). Définis des stratégies DLP pour la Power Platform afin de contrôler les connecteurs, pour que personne ne puisse par exemple créer un flux qui extrait des données d'une liste SharePoint sensible et les publie vers un service externe. Prévois aussi plusieurs environnements (Dev/Test/Prod) correctement sécurisés, afin que les « Citizen Developers » qui construisent des agents ou des applications n'exposent pas de données par inadvertance. L'objectif est d'éviter que la Power Platform ne devienne une porte dérobée non gouvernée vers tes données.
Étape 10 : former et outiller tes créateurs d'agents
Enfin, rédige des lignes directrices et des bonnes pratiques pour celles et ceux qui vont construire ou déployer des agents IA, qu'il s'agisse de développeurs professionnels ou d'utilisateurs métier. Mets en place des formations sur la manipulation sûre des données : comment choisir les bonnes sources de connaissances pour un agent, pourquoi ne pas intégrer de fichiers sensibles dans un agent largement partagé, comment tester les réponses d'un agent pour repérer des informations inattendues. En développant une culture attentive aux données chez les « agent makers », tu réduis le risque qu'une personne expose des informations par inadvertance en concevant une solution d'IA.
Sources :
- https://techcommunity.microsoft.com/blog/microsoft365copilotblog/from-oversharing-to-optimization-deploying-microsoft-365-copilot-with-confidence/4357963
- https://techcommunity.microsoft.com/blog/microsoft365copilotblog/microsoft-graph-connectors-update-expand-copilot%E2%80%99s-knowledge-with-50-million-ite/4243648
Une fois ces étapes terminées, tu peux passer en toute sécurité à la construction d'agents productifs. Pour cela, Microsoft propose différentes plateformes et fonctionnalités sur lesquelles nous pouvons nous appuyer, et tu trouveras les exemples les plus connus dans le chapitre suivant. Si tu as besoin d'aide pour dérouler cette liste, contacte-nous, nous t'accompagnons volontiers dans ce travail de préparation essentiel.
Rien ne t'empêche entre-temps de créer des PoC ou des agents de test avec des données d'exemple, des fichiers chargés manuellement ou des données spécifiques rattachées via RAG. Nous recommandons toutefois ces étapes avant toute implémentation ou tout déploiement d'agents à plus grande échelle.
Comprendre les différences entre les plateformes d'agents
Étape 1 : comprendre qui crée tes agents
Une fois le travail de fond sur les données terminé, il faut comprendre quelles plateformes permettent de créer ces agents. Nous essayons de distinguer ces outils selon leurs fonctionnalités et leurs possibilités, mais il est important de noter que la création d'agents et le choix des bons outils s'inscrivent dans un continuum. Il existe plusieurs façons de construire des agents IA dans l'écosystème Microsoft, et il faut choisir celle qui correspond à tes besoins et au niveau de compétence de ton équipe. Cela permet aussi de savoir quand recourir à Azure AI Foundry plutôt qu'aux outils intégrés de Copilot Studio.
Microsoft propose aujourd'hui toute une série d'outils permettant de construire des agents. Même s'ils se ressemblent, ils s'adressent à des publics et à des niveaux d'expertise différents. Regarde de plus près la vue d'ensemble ci-dessous. Comprendre qui doit créer et maintenir ces agents nous indique aussi quelles sources de connaissances, et donc quelles données, nous devons préparer pour eux. Au-delà des outils de cette liste, il existe encore d'autres solutions pro-code pour construire des agents, comme le M365 Agents Toolkit, Visual Studio Code, l'Agent SDK et d'autres. Toutes nos étapes de préparation des données s'appliquent également à elles, puisqu'elles accèdent aux mêmes données que les autres agents.
Source : https://www.egroup-us.com/news/microsoft-copilot-ai-integration/

Étape 2 : identifier les cas d'usage et les exigences pour ta plateforme
Tu t'en doutes, toutes les plateformes ne couvrent pas tous les cas d'usage. Les agents peuvent servir à des tâches simples, comme répondre à des questions à partir de connaissances existantes, ou à des tâches complexes, comme générer automatiquement des réponses ou exécuter des processus. L'expérience utilisateur finale, c'est-à-dire où et comment nous voulons accéder à ces agents, pèse aussi dans le choix d'une plateforme.
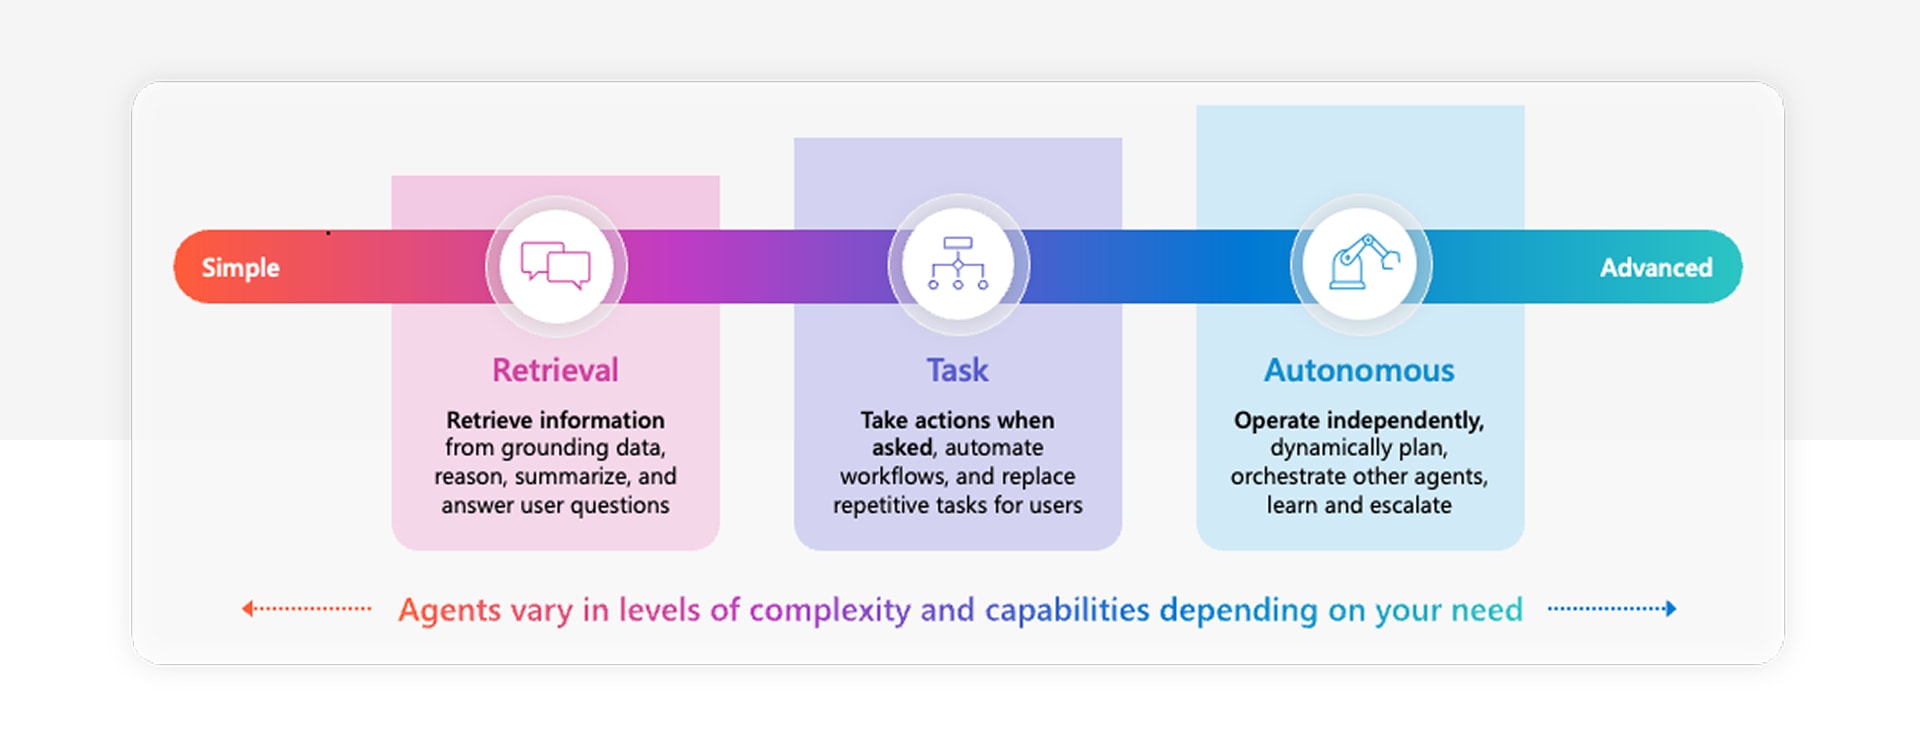
Avec ces considérations en tête, nous essayons en général d'utiliser la solution la plus simple possible pour construire un agent. Il faut toutefois aussi trouver une solution capable d'évoluer avec les développements futurs, sans pour autant construire chaque agent sur Azure AI Foundry dès le départ.
Conseil :
Si tu ne sais pas par où commencer pour construire ton agent, tu peux toujours partir de Copilot Studio, y intégrer des données supplémentaires depuis Azure AI et publier l'agent dans Microsoft 365 Copilot. Tu obtiens ainsi une compatibilité « vers le haut et vers le bas ».
RAG (Retrieval-Augmented Generation) vs. SharePoint vs. upload
Au premier regard, tout ressemble à du RAG, mais il y a des différences. Quand on découvre les Copilot Agents et leurs capacités, on est tenté de croire que toute intégration de connaissances suit le même schéma RAG (Retrieval-Augmented Generation). Vues de l'extérieur, toutes ces approches ressemblent à du RAG, puisqu'elles récupèrent des documents pour générer des réponses, mais leur fonctionnement interne diffère sensiblement. Comprendre ces différences est indispensable pour choisir la bonne approche en fonction de tes objectifs, de l'échelle visée et de ta maturité technique. En voici une brève explication et une vue d'ensemble.
Upload manuel de fichiers
L'upload manuel est la façon la plus simple d'ajouter des connaissances à un Copilot agent. Tu glisses-déposes les documents directement dans l'interface de Copilot Studio, Microsoft indexe automatiquement ces fichiers et en extrait le contenu pertinent lors d'une requête utilisateur. C'est idéal pour de petits pilotes et les premiers tests. Garde aussi à l'esprit que le contenu de ces fichiers doit pouvoir être consulté par toute personne ayant accès à l'agent. Il n'y a ici aucune gestion des autorisations dont tu devrais t'occuper. En contrepartie, tu devras mettre à jour ces fichiers manuellement sur la durée si quelque chose change. Pour les Copilot Agents, tu peux actuellement ajouter jusqu'à 20 fichiers manuellement.
SharePoint Online
Cette méthode utilise la Retrieval API de Microsoft pour accéder directement aux contenus de SharePoint Online, connecté via un Graph Connector. L'agent récupère en direct, au moment de la requête, les contenus les plus pertinents, en respectant les autorisations Microsoft 365 existantes. Il peut s'agir de sites SharePoint, de bibliothèques de documents, de dossiers ou de fichiers. L'approche est dynamique, sécurisée et se prête bien à un déploiement dans plusieurs départements ou unités métier sans avoir à gérer sa propre infrastructure. Comme elle s'appuie sur l'infrastructure existante, elle profite du modèle de sécurité intégré de SharePoint, ce qui représente un avantage considérable par rapport aux autres sources de connaissances. Les départements peuvent facilement mettre à jour les fichiers, et ces changements se reflètent dans l'agent. Si deux utilisateurs disposant de niveaux d'accès différents interrogent l'agent, l'un peut donc obtenir une réponse tirée d'un fichier donné tandis que l'autre, qui n'y a pas accès, ne l'obtiendra pas, et c'est exactement le comportement souhaité.
À noter : les listes SharePoint ne sont actuellement pas prises en charge comme source de connaissances, il n'est donc pas possible de les indexer nativement (T3 2025).
RAG personnalisé (autogéré)
Dans une configuration RAG classique, tu construis et gères toi-même l'ensemble de la pipeline de récupération : prétraitement des documents, chunking, embedding, stockage dans une base de données vectorielle et récupération des meilleures correspondances au moment de la requête. Tu gardes ainsi un contrôle total sur la manière dont les contenus sont traités et récupérés, mais au prix d'une complexité et d'un effort de maintenance accrus. Cette approche convient surtout aux cas d'usage avancés qui exigent une personnalisation allant au-delà de ce que proposent les services managés de Microsoft. Il ne s'agit pas d'une fonctionnalité intégrée à Copilot ou à Copilot Studio : nous la mettrions en œuvre dans Microsoft Azure.
Un RAG autogéré peut par exemple devenir nécessaire si tu dois connecter un agent IA à une base de données propriétaire ou à des milliers de PDF stockés en dehors de Microsoft 365 et y appliquer des filtres personnalisés. Cela demande toutefois un effort considérable.
Source : https://learn.microsoft.com/en-us/azure/search/retrieval-augmented-generation-overview?tabs=docs
Que choisir et quand
Les trois approches reposent toutes sur la récupération de contenus pour alimenter la génération de texte, mais seule la solution personnalisée et autogérée constitue du « vrai RAG » au sens technique. Pour la plupart des organisations qui débutent, l'upload manuel ou la connexion à SharePoint sont nettement plus simples et plus rapides à mettre en place. Ils donnent de bons résultats avec un minimum de configuration et permettent aux équipes de se concentrer sur la conception des cas d'usage et sur l'adoption plutôt que sur l'infrastructure.
Mon conseil général sur ce point :
Construis tes agents aussi près de tes données que possible
Exemple : si tes données se trouvent dans de grandes bases SQL ou dans des systèmes CRM externes, un SharePoint Agent ne fera pas l'affaire. Si toutes nos connaissances sont dans SharePoint, les SharePoint Agents ou les Copilot Agents peuvent constituer un bon point de départ.
Un RAG personnalisé ne devrait être envisagé que lorsque tes besoins dépassent ce que les options managées peuvent offrir, et non comme point de départ par défaut. L'upload manuel convient très bien pour un premier pilote ou pour de petits pilotes reposant sur des connaissances limitées, spécifiques et rarement mises à jour. Dans de nombreux scénarios, nous utiliserions simplement une bibliothèque ou un site SharePoint avec l'agent. C'est pourquoi nous nous concentrons sur le scénario suivant :
Microsoft 365 Copilot & Copilot Agents : sécurité et conformité intégrées
Une infrastructure cloud sécurisée est le socle de l'IA en entreprise. En plaçant nos agents dans le contexte de Microsoft 365 Copilot, Microsoft les fait bénéficier du cadre de sécurité de la plateforme. Chaque organisation peut s'appuyer sur son cadre de sécurité existant, fondé sur le Conditional Access et l'authentification multifacteur pour les accès, ainsi que sur son cadre de gouvernance existant, fondé sur Microsoft Purview.
Les agents utilisés dans M365 Copilot ou publiés depuis Copilot Studio sous forme de chatbot Teams ne sont accessibles qu'à l'intérieur des limites de notre tenant. Nous obtenons donc pour ces applications le même niveau de sécurité que celui dont nous disposons déjà.
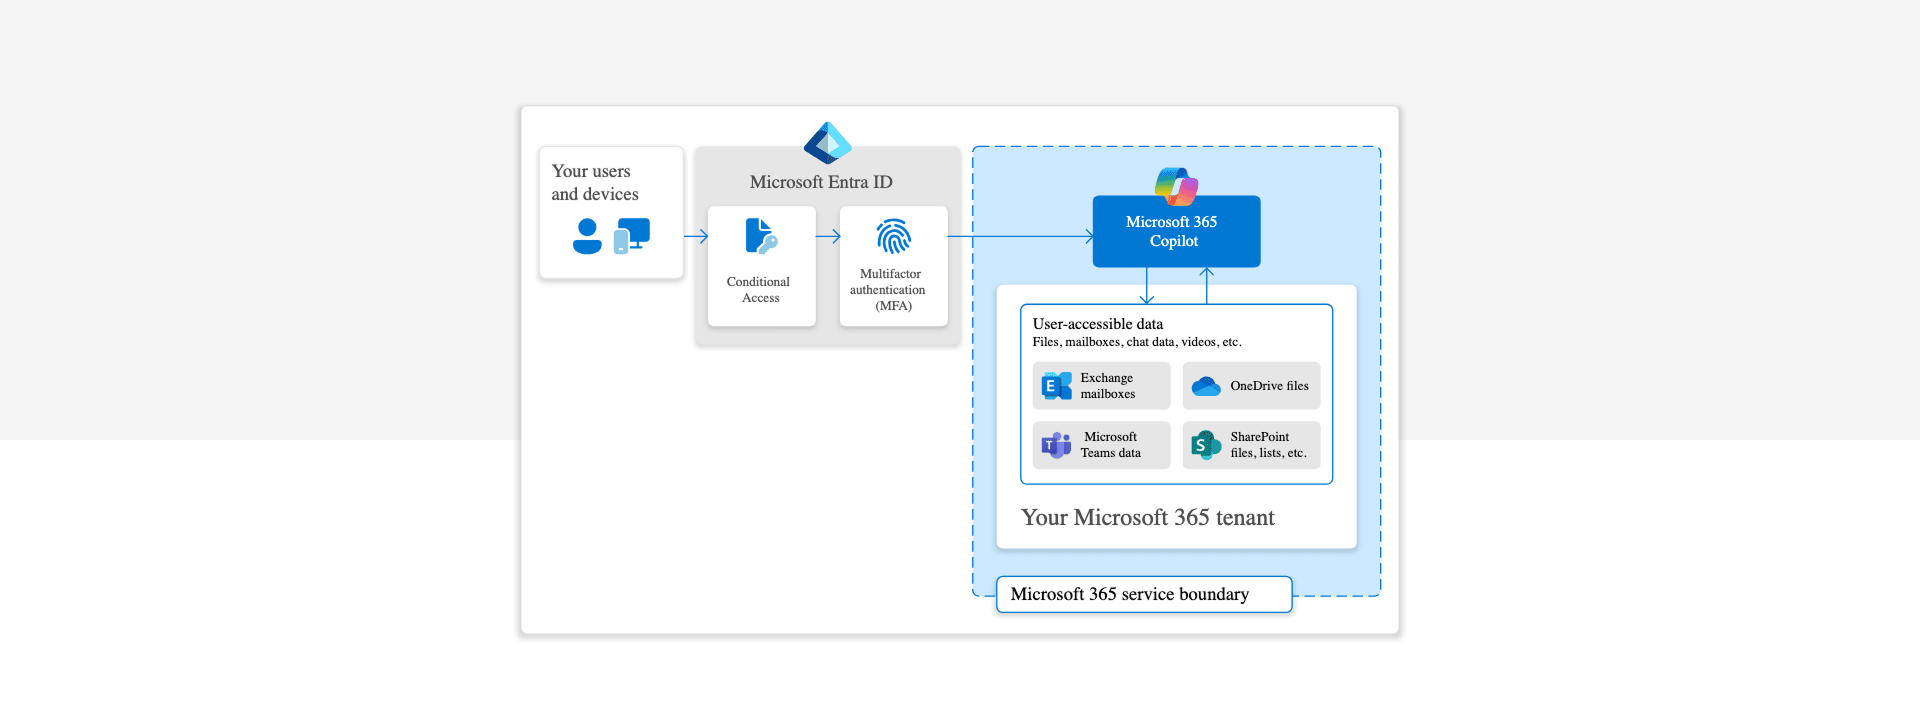
Microsoft prend en outre plusieurs engagements techniques et organisationnels, regroupés sous le nom d'« Enterprise Data Protection ».
Microsoft 365 Copilot : Enterprise Data Protection (EDP) pour les prompts et les réponses
- Protection contractuelle : les prompts (saisies de l'utilisateur) et les réponses (sorties de Copilot) sont protégés par le Data Protection Addendum (DPA) et les Product Terms. Ces protections sont les mêmes que celles qui s'appliquent aux e-mails dans Exchange et aux fichiers dans SharePoint.
- Sécurité des données : chiffrement au repos et en transit, contrôles de sécurité physique, isolation des données au niveau du tenant
- Engagements de confidentialité : Microsoft agit en tant que sous-traitant et n'utilise les données que selon les instructions du client. Prise en charge du RGPD, de l'EU Data Boundary, de l'ISO/IEC 27018 et d'autres référentiels.
- Contrôle d'accès et héritage des stratégies : Copilot respecte les modèles d'identité et les autorisations, les sensitivity labels, les stratégies de rétention, les paramètres d'audit et les configurations d'administration. Pour l'atténuation des risques liés à l'IA et au droit d'auteur, il protège contre les prompt injections, les contenus nuisibles et les problèmes de droit d'auteur (via la détection de contenus protégés et le Customer Copyright Commitment).
- Pas d'entraînement de modèles : les prompts, les réponses et les données Microsoft Graph ne sont PAS utilisés pour entraîner les modèles de fondation.
Copilot Agents avec des connaissances SharePoint Online :
- Modèle d'autorisations et de partage : les agents qui accèdent à SharePoint Online respectent toujours les autorisations du site SharePoint concerné. Cela signifie que tu dois d'une part t'assurer que toutes les personnes censées y avoir accès disposent au moins d'un droit de lecture sur le site, et d'autre part veiller à ne pas accorder d'autorisations superflues qui pourraient exposer des informations sensibles à des utilisateurs non autorisés. Une configuration correcte des autorisations est essentielle, car les Copilot Agents ne peuvent accéder et faire remonter que les contenus que l'utilisateur qui les interroge a le droit de voir. Par ailleurs, la protection des informations de Microsoft Purview garantit que les sensitivity labels et les stratégies de data loss prevention (DLP) restent attachés aux contenus.
- Labels persistants et DLP : active la protection des informations de Microsoft Purview afin que les sensitivity labels restent attachés aux contenus. Les Copilot agents héritent des labels des documents sources : si un fichier est classé « Confidential », tout contenu ou document généré par l'IA à partir de celui-ci portera désormais ce label. Cet héritage persistant des labels fonctionne de pair avec les stratégies de Data Loss Prevention pour empêcher l'IA d'exposer par inadvertance des données protégées. Concrètement, même si Copilot résume un fichier sensible, ce résumé sera lui aussi traité comme sensible. On ne trouve pas cela en dehors de Microsoft 365, et aucun autre agent IA ne s'intègre aussi profondément dans l'écosystème Microsoft 365.
Bonnes pratiques pour préparer davantage SharePoint Online à l'usage des agents
Pour préparer SharePoint Online à une utilisation efficace avec les Copilot Agents, suis ces bonnes pratiques :
Un site SharePoint dédié
Commence par créer un site SharePoint dédié ou un dossier spécifique réservé exclusivement à la base de connaissances de ton Copilot Agent. Cette approche limite les problèmes d'oversharing et réduit le risque que des utilisateurs déposent par erreur des fichiers sensibles ou hors sujet dans l'espace auquel l'agent a accès. Si tu choisis d'utiliser un site SharePoint existant, examine soigneusement son contenu pour t'assurer qu'il ne contient aucune information confidentielle ou sensible que l'agent ne devrait pas pouvoir trouver.
Accorder les accès
Il est également important de vérifier que tous les utilisateurs visés disposent des droits de lecture nécessaires sur le site ou le dossier. Si tu dois accorder les accès manuellement, donne aux utilisateurs concernés un accès en lecture au site, par exemple en les ajoutant au groupe Visitors du site SharePoint ou à un groupe de sécurité Azure AD approprié. Cela simplifie le processus et évite les erreurs de configuration des autorisations.
Préparer les fichiers
Lorsque tu prépares des documents pour les Copilot Agents, garde à l'esprit que l'IA ne sait pas encore interpréter les images intégrées dans les fichiers. Ajoute donc des légendes descriptives ou un texte alternatif pour que les informations visuelles importantes ne se perdent pas. Pour les documents riches en texte, limite le volume total à 1,5 million de mots ou 300 pages au maximum lorsque Copilot doit résumer ou citer le contenu, afin qu'il fonctionne efficacement.
Pour les fichiers Excel, organise tes données de façon à ce que chaque fichier porte soit sur des chiffres, soit sur du texte, car les tableaux au contenu mixte donnent généralement des résultats moins précis. Les agents répondent aussi de manière plus fiable lorsque les données pertinentes se trouvent dans une seule feuille du classeur.
Les agents exploitent le mieux les données Excel lorsqu'elles tiennent dans une seule feuille.
Exemple : si tu as une grande enquête de satisfaction client stockée dans un seul fichier Excel, sépare les données quantitatives (notes, réponses chiffrées) des données qualitatives (commentaires en texte libre) dans deux feuilles distinctes. Tu peux ainsi analyser efficacement les données chiffrées avec des outils comme Python et les formules Excel (calcul de moyennes, tri des résultats, détermination des niveaux de confiance), tout en t'appuyant sur les fonctions d'analyse de sentiment de M365 Copilot pour tirer des enseignements des retours écrits.
Limites des fichiers
Enfin, tiens compte des types de fichiers et des limites de taille pris en charge par les Copilot Agents et Copilot Studio. Le tableau suivant présente l'état actuel : https://learn.microsoft.com/en-us/microsoft-365-copilot/extensibility/copilot-studio-agent-builder-knowledge#file-size-limits
Tiens compte aussi des bonnes pratiques publiées par Microsoft sur la longueur des documents : https://support.microsoft.com/en-gb/topic/keep-it-short-and-sweet-a-guide-on-the-length-of-documents-that-you-provide-to-copilot-66de2ffd-deb2-4f0c-8984-098316104389
| Type de fichier | SharePoint Online - limite | Upload manuel - limite |
|---|---|---|
.doc | 150 MB | 100 MB |
.docx | 512 MB | 100 MB |
.html | 150 MB | non pris en charge |
.pdf | 512 MB | 100 MB |
.ppt | 150 MB | 100 MB |
.pptx | 512 MB | 100 MB |
.txt | 150 MB | 100 MB |
.xls | 150 MB | 100 MB |
.xlsx | 150 MB | 100 MB |
Types de fichiers actuellement non pris en charge dans SharePoint Online : tout ce qui ne figure pas dans cette liste n'est officiellement pas pris en charge.
Certains types de fichiers, comme les CSV, peuvent fonctionner correctement sans être officiellement pris en charge, parce qu'ils sont très proches du texte brut. La plupart des autres types de fichiers, en particulier les conteneurs comme CAB, EXE ou ZIP, ainsi que les formats image, vidéo et audio tels que PNG, IMG, MP3 et MP4, ne sont en revanche pas pris en charge à l'heure actuelle.
Pour conclure
En suivant ces recommandations, tu t'assures que tes Copilot Agents accèdent à des données bien structurées, sécurisées et de bonne qualité, ce qui maximise leur utilité et réduit au minimum le risque d'exposition accidentelle de données. Le temps investi dans la préparation de ton environnement SharePoint pose des bases solides pour réussir le déploiement et l'adoption d'agents IA dans ton organisation.
D'ailleurs, beaucoup de nos projets « Build-an-Agent » commencent exactement par là : non pas par la construction de l'agent, mais par la préparation de l'infrastructure et des connaissances, afin de disposer de données de bonne qualité pour l'IA. Car un agent ne vaut que ce que vaut le système sur lequel il repose.

Agent-Ready Infrastructure : ta base pour des Copilot Agents productifs
Une IA ne vaut que ce que vaut l'infrastructure sur laquelle elle tourne. Pour utiliser sérieusement les Copilot Agents au quotidien, une licence et une activation ne suffisent pas. Il faut des données structurées, une gouvernance cohérente et une architecture réfléchie qui passe à l'échelle, en un mot : une Agent-Ready Infrastructure.
Dans notre présentation en anglais, nous te montrons :
- Pourquoi la qualité des données et l'architecture de l'information sont décisives
- Comment préparer ton environnement Microsoft 365 à des agents productifs
- Et quels leviers actionner dès aujourd'hui pour que ton entreprise tire réellement profit de l'IA demain
Ähnliche Artikel

Autopilot Device Preparation devient le standard, Hybrid Join reste à la traîne
Depuis septembre, Microsoft recommande Autopilot Device Preparation comme méthode standard pour les déploiements Windows en mode user-driven. Le nouveau processus ...
Les extensions de navigateur, un angle mort dans l'entreprise
Les extensions de navigateur font depuis longtemps partie du poste de travail numérique normal. Traducteurs, gestionnaires de mots de passe, ...

Qui a créé ces agents ?
E7 regroupe E5, Copilot, l'Entra Suite et Agent 365. Mais une licence ne remet pas un tenant en ordre. C'est ...
La fin de la MFA par SMS
Pourquoi les entreprises doivent passer dès maintenant à des méthodes de connexion résistantes au phishing et, dans la mesure du ...
ClickFix. Quand l'utilisateur devient l'exploit, et comment l'arrêter
ClickFix fait de l'utilisateur son propre attaquant : un faux CAPTCHA, un copier-coller, et le code malveillant s'exécute en mémoire ...
Admin et quotidien sur le même poste ? Game Over.
Pourquoi un seul tenant ne suffit pas aux DSI, et pourquoi on pense rarement au second. Le Managed Red Tenant ...
Quatre fois Leader. glueckkanja dans l'étude ISG Allemagne 2026
L'étude ISG Provider Lens® 2026 positionne glueckkanja en Allemagne comme Leader dans quatre quadrants : Microsoft Productivity and Business Process ...
De Rising Star à Leader. glueckkanja dans l'étude ISG Suisse 2026
L'étude ISG Provider Lens® 2026 positionne glueckkanja comme Leader en Suisse dans le quadrant Microsoft AI and Cloud Ecosystem, dans ...
Outbreak. Ce que l'incident OpenAI/Hugging Face révèle, et ce qu'il ne révèle pas
Un agent IA s'échappe de son environnement de test, trouve une faille zero-day et pirate une autre entreprise. On croirait ...
Leader et Rising Star. glueckkanja dans l'étude ISG Cybersecurity 2026
L'étude ISG Provider Lens® Cybersecurity 2026 distingue glueckkanja comme Leader dans le quadrant Next-Gen SOC/MDR Services (Midmarket). Sur l'ensemble du ...
The Holy Trinity : ce dont l'IA a vraiment besoin pour travailler
Un industriel veut savoir lesquelles de ses 14 000 références sont réellement rentables. La réponse se trouve dans trois systèmes ...
Contrat signé : voici comment se déroule ton onboarding chez nous
Le contrat est signé, le premier grand pas est franchi. Reste à savoir ce qui se passe ensuite. Nous t'emmenons ...
Microsoft Frontier Partner : nous en faisons partie
Le Microsoft AI Cloud Partner Program compte depuis peu une nouvelle distinction de premier rang, le Frontier Partner Badge. Microsoft ...
160 kilomètres pour la bonne cause
Onze collègues, 16 tours, 160 kilomètres, un orage et une place sur le podium : glueckkanja a participé aux Frankfurter ...

Anatomie d'un AMOS Stealer inconnu : de l'alerte à l'immunité en quelques heures
Une variante jusqu'ici non documentée d'AMOS Stealer a compromis un endpoint macOS. Aucun hash connu, aucune donnée C2 dans les ...