

2025年にエージェント対応であるために堅牢なインフラが必要な理由
Microsoft 365 Copilot Agentsが本当の価値を生む前に、土台が固まっている必要があります。整理されたデータ、適切なアクセス権、そして信頼できるインフラです。本稿では、データ品質がAIの成果を左右する理由を説明し、過剰共有やサイロ化といったリスクを取り上げ、M365環境を安全かつコンプライアンスに適合し、スケールするエージェント対応の状態にするための10の実践的なステップを示します。

プロローグ
これだけどこにでもAIがある状況では、多くのアイデアが生まれ、何かを始めたい、少なくとも試してみたいという気持ちが湧いてきます。glueckkanja AGはこの過程全体でお客様を支援しています。もちろん当社はすでにエージェントを設計し構築していますが、プロジェクトの80%では、エージェントを作るためのデータとテナントの準備が主な焦点になります。Copilotを自社で本番利用する前に、インフラを厳しい目で見直しておく価値があります。この領域で判断を下すときには、AIエージェントを大規模に展開する前に理解しておくべき重要な点がいくつもあります。そこで本稿では、欠かせないステップと違いを順に案内します。Microsoft 365 Copilot Agentsのようなアシスタントが働き方を変えると言われる時代に、何よりもまず当てはまる原則があります。AIはその下にあるシステムの出来を超えられません。
本ガイドでは、Copilot Agentsに向けてデータとインフラをどう整えるかを解説し、SharePoint、Teams、Power Platformでの要点を取り上げます。
インフラ(データ)が重要な理由
AIエージェントを使ううえで欠かせない前提があります。エージェントは、自社のこと、自社のデータ、自社固有の業務文脈を、そのままでは知りません。既定では、AIエージェントが持っているのは大規模言語モデル(LLM)の学習に由来する組み込みの知識だけです。エージェントの能力を実際に高め、広げるには、さまざまな要素を体系立てて組み合わせる必要があります。具体的には、システムプロンプト、ナレッジベース、コネクタ、Web検索機能、Microsoft Graphへのアクセス、セマンティック検索、その他のツールを組み込むことです。これらが揃ってはじめて、AIエージェントは自社固有のニーズとデータに沿った、より正確で文脈に合った回答や動作を返せるようになります。エージェント時代はまだ始まったばかりなので、多くの人は既存のSharePoint Onlineのライブラリから情報を取得する単純なエージェントから着手することになります。
つまりIT部門にとっては、SharePoint Onlineのデータをこれまで以上に手当てする必要があるということです。
SharePoint Online = 知識 = データ、そしてデータ = 鍵
私からのはっきりしたメッセージです。AIのcopilotを自社に迎える前に、データの家を片づけてください。Copilot Agentsに与えるデータは、Microsoft 365 Copilot自身が使うデータでもあります。
それだけではありません。Microsoft 365 Copilotも同じデータを見ています。*データが散らかり、過剰に共有され、保護が甘ければ、AIは誤った情報や機微な情報を思わぬかたちで表に出しかねません *たとえば、会社の組織構成をCopilotに尋ねたら、本来見えてはいけない機密の組織再編案の詳細が返ってくる場面を想像してください。こうしたことは、SharePointやTeamsのようなプラットフォームでコンテンツが過剰共有されている(広く行き渡りすぎている)ときに起こります。補足すると、Copilotは既存のアクセス権をすべて尊重します。つまりこのようなことは、アクセス権の設定が誤っている場合にしか起こりません。逆に、データがサイロに閉じていたり参照できなかったりすれば、AIアシスタントの役立ち方は落ちます。
Copilotが提示する社内データは、そのユーザー自身が少なくとも閲覧権限を持つものだけです。
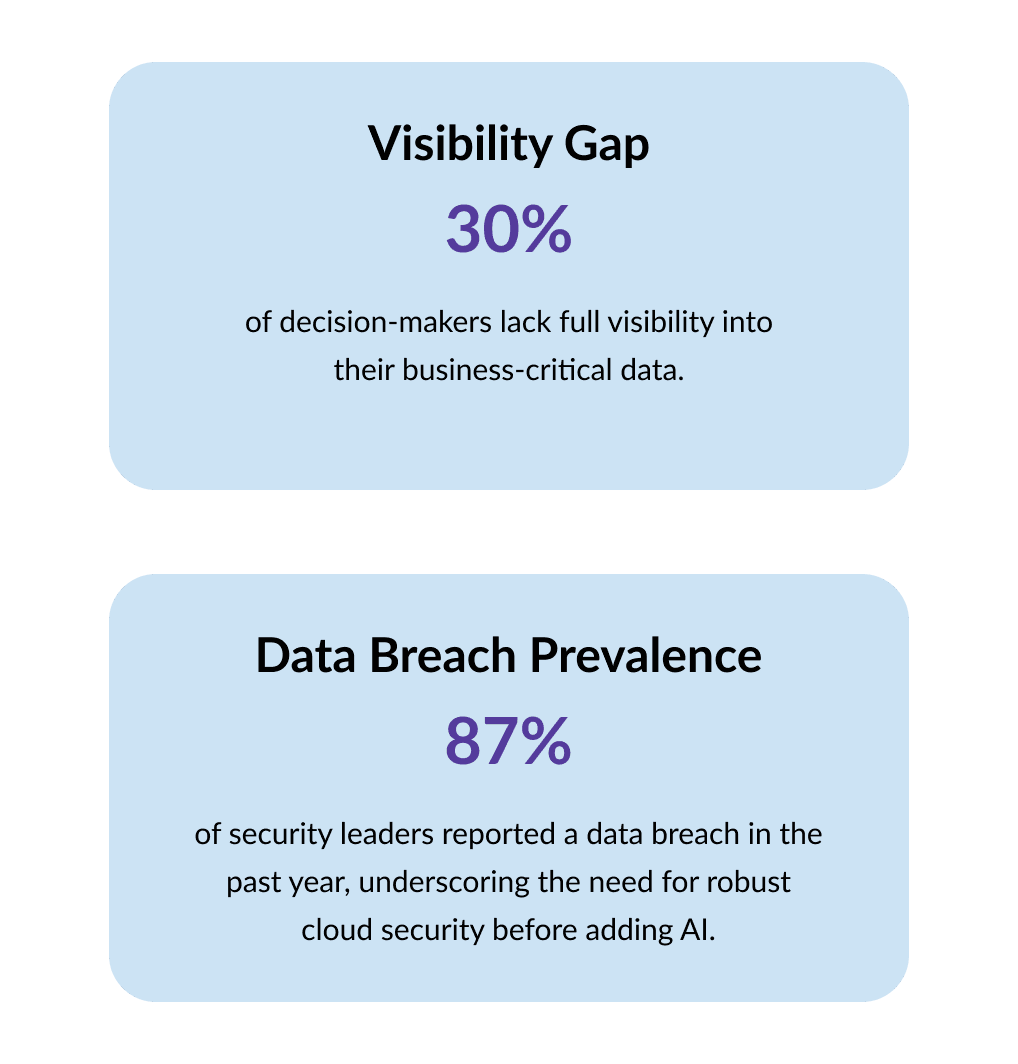
要点です。企業でのAIは、しっかりしたデータ基盤があってはじめて成功します。最近のMicrosoftのレポートは、AI導入前に片づけるべき最大の課題としてデータの過剰共有、データ漏えい、規程に反した利用を挙げています。SharePoint Onlineをはじめとするデータソースの準備に投資した組織は、安心してCopilotの利点を引き出せます。そうしなかった組織は、セキュリティ侵害や的外れなAI出力のリスクを背負います。意思決定者のおよそ3分の1が、重要なデータを十分に把握できていないという調査結果もあります。
M365データ基盤をいますぐ改善する10のステップ
エージェントにデータが必要なことは、ここまでで分かりました。glueckkanjaがこうしたプロジェクトに入るとき、お客様と上から順に片づけていく典型的な10項目のリストが次のものです。
ステップ1:主要な共有設定を確認する
過剰共有につながりかねないテナント全体の設定を確かめます。たとえば、既定の共有リンクのポリシー(SharePointやOneDriveで「リンクを知っている全員」や「組織内のユーザー」が既定で許可されているか)、ユーザーが既定でパブリックなTeamsを作れるか、Power Platform環境がガバナンスなしに開放されていないか、といった点です。ここでの設定ミスは、意図しない広範なアクセスのよくある原因です。。
ステップ2:パブリックなTeamsを棚卸しする
「パブリック」に設定されているMicrosoft Teamsをすべて確認します。パブリックなチームでは、組織内の誰でも その内容を見つけてアクセスできます。パブリックに設定されているチームには、機微でなく広く共有してよい内容だけが入っていることを確かめてください。そうでなければプライベートに切り替えるか、メンバー構成を見直します。(チームがパブリックのまま作られ、その後忘れ去られて、ファイルが全従業員に見えてしまうのはよくあることです。)
ステップ3:Graph Connectorsを見直す
サードパーティのデータ(外部ファイルシステムやwikiなど)を取り込む Microsoft Graph Connectors がテナントに設定されていないか確認します。全員が見るべきでないデータをインデックスしているコネクタは、削除するか保護してください。なぜか。Graph Connectors経由でインデックスされたコンテンツは、Microsoft Graphの検索インデックスの一部になります。つまりCopilotがプロンプトへの回答にそれを使う可能性があります。接続しておきたいのは、意図した関連性のあるデータソースだけです。
ステップ4:SharePoint Online Baseline Reportを作成する
SPOには、エージェントやCopilotに望まないデータが流れ込むリスクがいくつもあります。次のような指標を見る必要があります。
- フォルダー単位での権限継承の断ち切り
- パブリックなSharePointサイト
- 「Everyone Except External Users」や、全ユーザーを含むその他の動的グループの利用
- 「リンクを知っている全員」の共有リンク
- 「組織内のすべてのユーザー」の共有リンク
- サイト管理者/所有者/メンバー/閲覧者グループに入っている不適切な人
ステップ5:リスクを分類し優先順位をつける
ステップ1から4で見つかったものを、深刻度で並べ替えます。事業上とりわけ重要または機微なデータを抱え、かつ露出のリスクもあるサイトやファイルはどれでしょうか。そこから直していきます。業務上の文脈を重ねて見る(財務データのサイトと一般的なテンプレートのサイトを区別するなど)ことで、影響の大きい問題から取り組めます。
ステップ6:アクセス棚卸しにサイト所有者を巻き込む
リスクが高いと判明したSharePointサイト(またはチーム)については、サイト所有者に誰がアクセスできるか、それが妥当かを改めて確認してもらいます。所有者は内容にいちばん近い立場にいるので、「なぜ 全員 がこれを読めるのか。おかしい」とすぐ気づけます。サイト管理者が定期的に権限を承認する仕組みを整えてください。
ステップ7:継続的な監督体制をつくる
新たな過剰共有を継続的に監視する仕組みを用意します。過剰共有の管理は一度直せば終わりではありません。新しいサイト、チーム、ファイルができるたびに、設定ミスを先回りで捉える必要があります。外部や巨大なグループへのファイル共有、新しく作られたパブリックチームなどを検知するために、Microsoft Purviewのレポートやアラートの利用を検討してください。Microsoftのツールはこうした条件のアラートを自動化できるので、良い状態を保つために活用してください。
ステップ8:秘密度ラベルとDLPポリシーを適用する
Microsoft Purviewの秘密度ラベルでデータを分類し(社外秘、最高機密など)、そのラベルを保護設定に結びつけます。たとえば「社外秘」ラベルはファイルを暗号化したり、外部共有を止めたりできます。あわせてデータ損失防止(DLP)のポリシーを設定し、機微な情報の過剰共有を防いだり監視したりします(顧客の社会保障番号の一覧をメールで送れないようにする、など)。これらのツールは日々の業務でのうっかりした漏えいを防ぐだけでなく、Copilotとも連動します。Copilotがラベル付きのコンテンツに本来してはいけない形でアクセスしたり出力したりしようとすれば、DLPが介入できます。さらに後述のとおり、Copilot自身も元文書のラベルを回答に引き継ぎます。
ステップ9:Power Platformのガバナンスを実装する
監督の範囲をPower Platform(Power Apps、Power Automateなど)にも広げます。Power Platform向けのDLPポリシーを定めてコネクタを制御します(機微なSharePointリストからデータを取り出して外部サービスに送るフローを作れないようにする、など)。あわせて、開発/テスト/本番の複数環境を適切なセキュリティとともに用意し、エージェントやアプリを作る「市民開発者」がうっかりデータを露出させないようにすることも検討してください。要するに、Power Platformが自社データへの野放しの裏口にならないようにするということです。
ステップ10:エージェント開発者を教育し支援する
最後に、AIエージェントを構築または展開する人たち(専門の開発者でも業務部門のユーザーでも)に向けたガイドラインとベストプラクティスを用意します。データを安全に扱うための研修を整えてください。エージェントに適した知識ソースの選び方、広く共有されるエージェントに機微なファイルを含めてはいけない理由、エージェントの出力に想定外の情報がないか確かめる方法などです。「エージェントを作る人」の間にデータを意識する文化を育てることで、AIソリューションの設計中にうっかり情報を露出させる可能性を下げられます。
出典:
- https://techcommunity.microsoft.com/blog/microsoft365copilotblog/from-oversharing-to-optimization-deploying-microsoft-365-copilot-with-confidence/4357963
- https://techcommunity.microsoft.com/blog/microsoft365copilotblog/microsoft-graph-connectors-update-expand-copilot%E2%80%99s-knowledge-with-50-million-ite/4243648
これらのステップを終えたら、安心して先へ進み、実用的なエージェントを作り始められます。エージェントを作るには、Microsoftが提供するいくつものプラットフォームや機能を使えます。代表的なものは次章にまとめました。このリストで手助けが必要なら、この大事な準備作業を一緒に進められるようご連絡ください。
その間に、サンプルデータや手動でアップロードしたファイル、RAGでつないだ特定のデータを使って、PoCやテスト用のエージェントを作ることは何も妨げられません。ただし、エージェントを大きく実装したり展開したりする前には、これらのステップを踏むことをお勧めします。
エージェントプラットフォームの違いを理解する
ステップ1:エージェントの作り手を理解する
データを整える土台づくりのあとは、そうしたエージェントを作るのにどのプラットフォームが使えるのかを理解する必要があります。当社はこれらのツールを機能と可能性で区別していますが、エージェントを作ることも適切なツールを選ぶことも幅のある話だと意識しておくことが大切です。Microsoftのエコシステムには、AIエージェントを作る方法が複数あります。自社のニーズとチームの習熟度に合ったものを選ぶことが重要です。どんなときにAzure AI Foundryを使い、どんなときにCopilot Studioの組み込み機能を使うのかも、そこで見えてきます。
Microsoftは現時点でエージェントを作れる複数のツールを提供しています。互いに似て見えますが、想定している対象者と専門性の水準はそれぞれ違います。下の一覧をよく見てください。誰がこれらのエージェントを作り、保守するのかが分かれば、エージェント向けにどの知識ソース(=データ)を整えるべきかも見えてきます。下の一覧にあるツールのほかにも、M365 Agents Toolkit、Visual Studio Code、Agent SDKなど、より本格的なコードベースの選択肢もあります。 当社のデータ準備の 手順´ はこれらにもそのまま当てはまります。他のエージェントと同じデータにアクセスするからです。
出典: https://www.egroup-us.com/news/microsoft-copilot-ai-integration/

ステップ2:プラットフォームのユースケースと要件を洗い出す
想像がつくとおり、どのプラットフォームもすべてのユースケースに対応するわけではありません。エージェントは、既存の知識に基づいて質問に答えるといった単純な用途にも、回答を自動生成したり業務プロセスを実行したりする複雑な用途にも使えます。また、そのエージェントをどこでどのように使いたいかという最終的な体験も、プラットフォーム選びの重要な判断材料です。
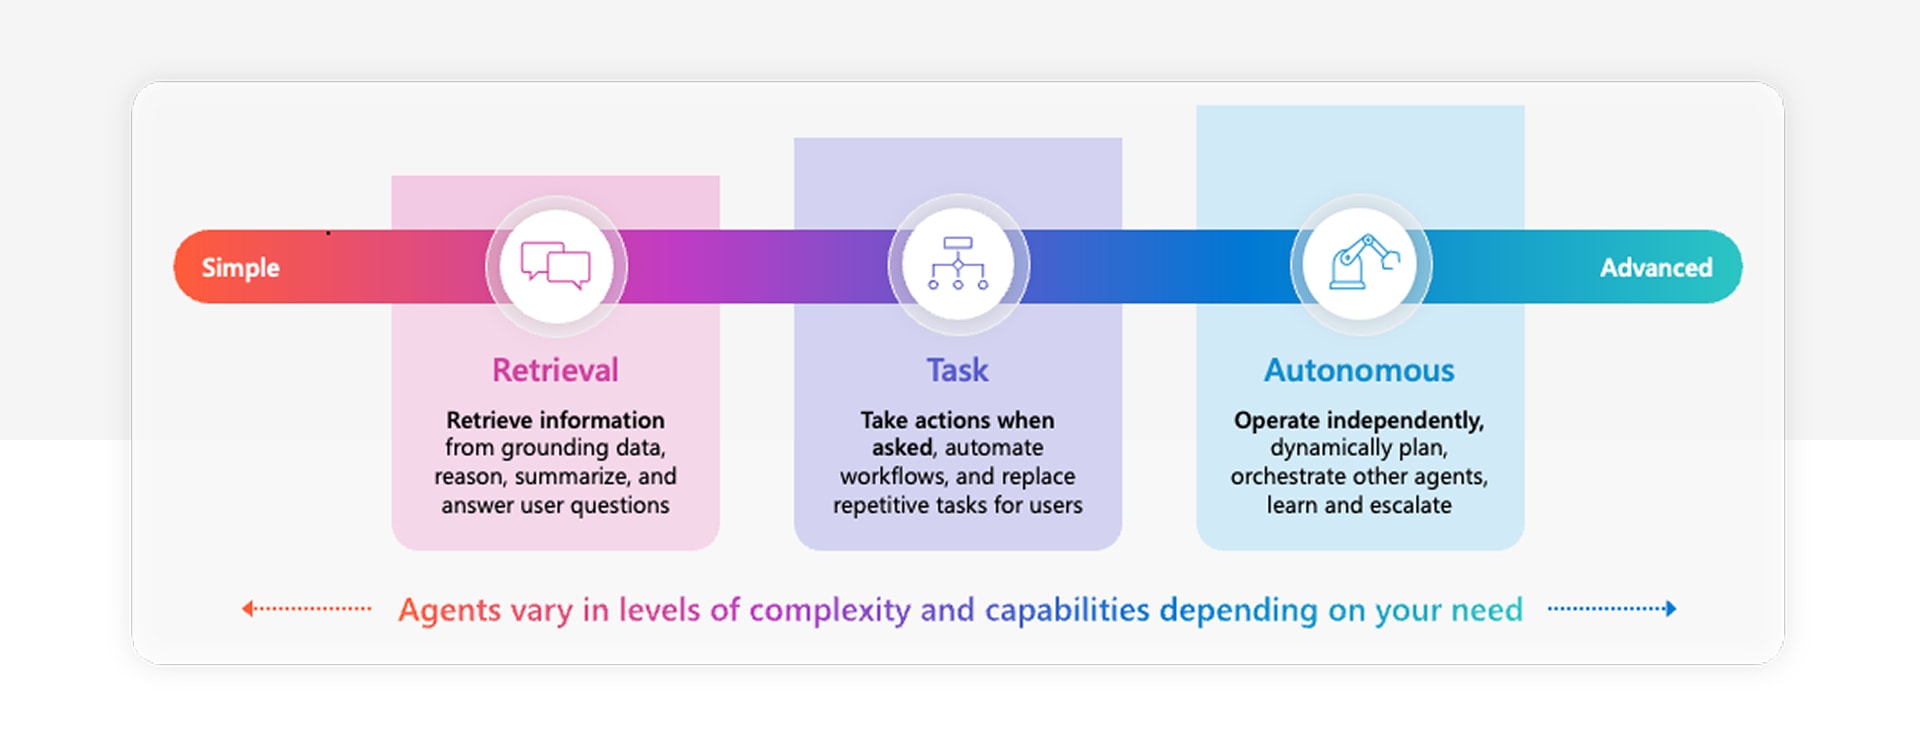
こうした点を踏まえ、当社はたいていエージェントの構築に使える最も簡単な方法を選びます。ただし同時に、その先の発展にも耐えてスケールする方法を見つける必要もあります。とはいえ、どのエージェントも最初からAgent AI Foundryの上に作らなければならないわけではありません。
ヒントです。
エージェントをどこから作り始めるか迷うときは、まずCopilot Studioを使い、必要に応じてそこにAzure AIのデータを追加したうえでMicrosoft 365 Copilotに公開するという手が常にあります。こうすれば上位互換と下位互換の両方が得られます。
RAG(Retrieval-Augumented Generation)とSharePointとアップロードの比較
最初に見たときは、どれもRAGに見えます。しかし違いがあります。Copilot Agentsとそのエージェント機能を初めて触ると、知識の統合はどれも同じRAG(Retrieval-Augmented Generation)の枠組みで動いていると考えたくなります。外から見れば文書を取ってきて回答を生成するという点でどれも_RAGのように_見えますが、内部の動き方は大きく違います。この違いを理解することは、目的、規模、技術的な準備度に応じて適切な方法を選ぶうえで欠かせません。以下に簡単な説明と概要を示します。
手動でのファイルアップロード
手動アップロードは、Copilotのエージェントに知識を追加する最も簡単な方法です。Copilot Studioの画面に文書をドラッグ&ドロップするだけです。Microsoftがこれらのファイルを自動でインデックスし、ユーザーの問い合わせ時に関連する内容を取り出します。小規模なパイロットや初期の検証にはうってつけです。なお、ファイルの内容はそのエージェントにアクセスできる全員が見られる前提で考えてください。ここには面倒を見るべき権限管理はありません。一方で、内容が変わったときには長期的に手作業で更新し続ける必要があります。現時点のCopilot Agentsでは、手動で追加できるファイルは最大20個です。
SharePoint Online
この方法では、MicrosoftのRetrieval APIを使い、Graph ConnectorでつないだSharePoint Onlineから直接コンテンツを取得します。エージェントは問い合わせのたびに最も関連する内容をその場で取り出し、既存のMicrosoft 365のアクセス権を尊重します。対象はSharePointサイト、ドキュメントライブラリ、フォルダー、ファイルです。動的で安全であり、自前のインフラを抱えずに部門や事業単位を越えて広げていくのに向いています。既存のインフラの上に積み上げることで、SharePointに組み込まれたセキュリティモデルをそのまま使えます。これは他の知識ソースにはない大きな利点です。各部門はファイルを気軽に更新でき、それがそのままエージェントにも反映されます。つまり、アクセス権の異なる2人のユーザーが同じ質問をした場合、一方はあるファイルに基づく回答を得られ、アクセス権のないもう一方は得られないということです。これはまさに望ましい振る舞いです。
補足:SharePointリストは現在サポートされている知識の種類ではないため、そのままではインデックスできません(2025年第3四半期時点)。
カスタムRAG(自己管理)
典型的なRAGの構成では、検索のパイプライン全体を自分で構築し運用します。文書の前処理、チャンク分割、埋め込み生成、ベクトルデータベースへの保存、問い合わせ時の上位候補の取得までが含まれます。コンテンツの処理方法と取得方法を完全に制御できる一方で、複雑さと保守の負担も生まれます。Microsoftのマネージドサービスで賄える範囲を超えたカスタマイズが必要な、高度なユースケース向けです。これはCopilotやCopilot Studioの組み込み機能ではなく、Microsoft Azure上で実装することになります。
RAGを使う場面の例としては、Microsoft 365の外にある独自データベースや数千件のPDFとAIエージェントを結び、独自のフィルターを効かせる必要がある場合が挙げられます。この場合は自己管理のRAGが必要になるかもしれませんが、相応の労力がかかります。
出典:https://learn.microsoft.com/en-us/azure/search/retrieval-augmented-generation-overview?tabs=docs
何をいつ選ぶか
3つの方法はいずれも、言語生成を支えるためにコンテンツを取得します。ただし技術的な意味で「本当のRAG」と言えるのは、自己管理のカスタム構成だけです。これから始める組織の多くにとっては、手動アップロードやSharePoint連携のほうが実装がはるかに簡単で速く済みます。最小限の準備で十分な成果が出ますし、チームはインフラではなくユースケースの設計と定着に集中できます。
この点についての私からの一般的な助言です。
エージェントは、できるだけ自社データの近くで作ってください
例を挙げます。データが大規模なSQLデータベースや外部のCRMにあるなら、SharePointのエージェントでは用を足しません。知識がすべてSharePointにあるなら、SharePointのエージェントやCopilotのエージェントから始めるのが良い選択になりえます。
カスタムRAGは、マネージドの選択肢で賄えない要件が出てきたときに初めて検討するもので、最初の出発点にするものではありません。手動アップロードは、最初のパイロットや、更新頻度が低く限定的で具体的な知識を扱う小さなパイロットに向いています。多くの場面では、SharePointのライブラリやサイトをそのままエージェントに使います。そのため当社は、次のようなシナリオを中心に考えています。
Microsoft 365 CopilotとCopilot Agents:標準で備わるセキュリティとコンプライアンス
安全なクラウドインフラは、企業でAIを使うための土台です。MicrosoftはエージェントをMicrosoft 365 Copilotの文脈に置くことで、考えうる最も堅牢な枠組みを提供しています。どの組織も、アクセス制御については条件付きアクセスと多要素認証(MFA)に基づく既存のセキュリティの枠組みを、ガバナンスについてはMicrosoft Purviewに基づく既存の枠組みをそのまま信頼できます。
M365 Copilotで使われるエージェントや、Copilot StudioからTeamsのチャットボットとして公開したエージェントには、自社テナントの境界の内側からしかアクセスできません。つまり、これらのアプリケーションにも、すでに持っているのと同じ水準のセキュリティが効きます。
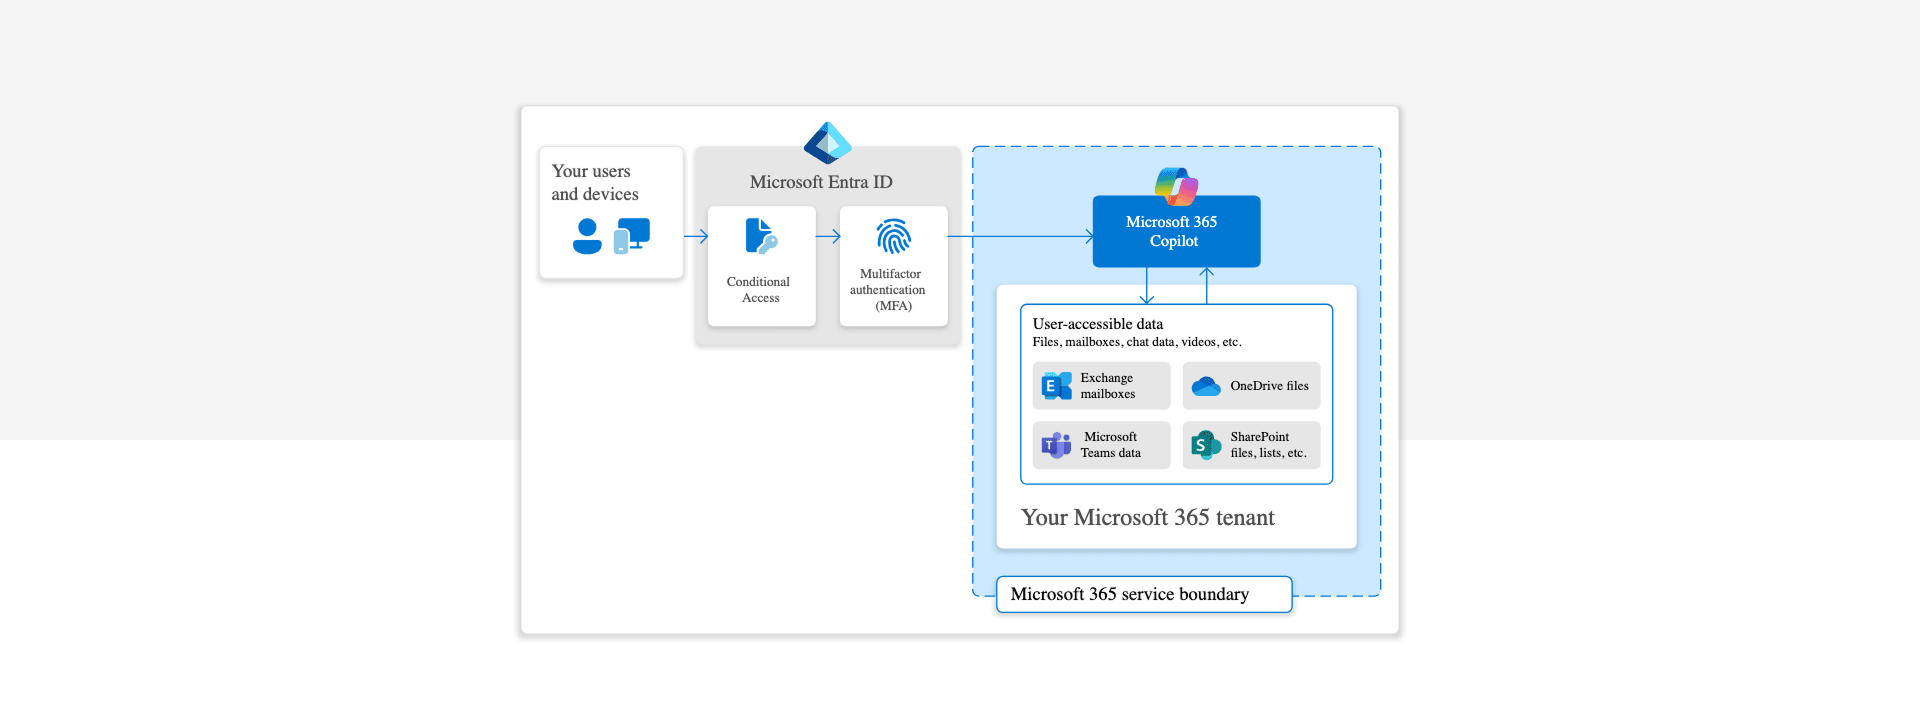
さらにMicrosoftは、いわゆる「Enterprise Grade Data Protection」としてまとめられた技術的・組織的な複数のコミットメントを示しています。
Microsoft 365 Copilot:プロンプトと応答のEnterprise Data Protection(EDP)
- 契約上の保護:プロンプト(ユーザーの入力)と応答(Copilotの出力)は、Data Protection Addendum(DPA)と製品条項のもとで保護されます。これはExchangeのメールやSharePointのファイルに適用されるのと同じ保護です。
- データのセキュリティ:保存時および転送時の暗号化、物理的なセキュリティ管理、テナント単位のデータ分離
- プライバシーに関するコミットメント Microsoftはデータ処理者として、お客様の指示に従ってのみデータを扱います。GDPR、EU Data Boundary、ISO/IEC 27018などに対応しています。
- アクセス制御とポリシーの継承:Copilotは次のものを尊重します。IDモデルとアクセス権、秘密度ラベル、保持ポリシー、監査設定、管理者による構成、AIと著作権のリスク低減、そしてプロンプトインジェクション、有害なコンテンツ、著作権上の問題(保護対象素材の検出とCustomer Copyright Commitmentによる)への防御
- モデルの学習には使わない:プロンプト、応答、Microsoft Graphのデータは、基盤モデルの学習には使われません。
SharePoint Onlineを知識源とするCopilot Agents:
- 権限と共有のモデル:SharePoint Onlineにアクセスするエージェントは、常に対応するSharePointサイトのアクセス権を尊重します。つまり、一方では、アクセスすべき全員がそのサイトに少なくとも読み取り権限を持っていることを確かめる必要があり、他方では、不要な権限を与えて機微な情報を権限のない人に見せてしまわないよう注意する必要があります**。アクセス権を正しく構成することが essentia**l です。Copilot Agentsは、問い合わせたユーザーが見てよいコンテンツしかアクセスも提示もできないからです。さらに、Microsoft Purviewの情報保護を使えば、秘密度ラベルとデータ損失防止(DLP)のポリシーがコンテンツとともに維持されます
- ラベルとDLPの持続:コンテンツとともに秘密度ラベルが維持されるよう、Microsoft Purviewの情報保護を有効にしてください。Copilotのエージェントは元文書のラベルを引き継ぎます。あるファイルが「社外秘」に分類されていれば、そこから生成されるコンテンツや文書もそのラベルを引き継ぐということです。このラベルの継承はデータ損失防止のポリシーと連動し、AIが保護対象のデータをうっかり露出させるのを防ぎます。実際には、Copilotが機微なファイルを要約した場合、その要約も機微なものとして扱われるということです。これはMicrosoft 365の外では見られない際立った特長であり、Microsoft 365のエコシステムにここまで深く統合されたAIエージェントは他に出てこないでしょう。
エージェント利用に向けてSharePoint Onlineをさらに準備するためのベストプラクティス
Copilot Agentsで効果的に使えるようSharePoint Onlineを整えるには、次のベストプラクティスに従ってください。
専用のSharePointサイト
まず、Copilotのエージェントのナレッジベース専用のSharePointサイト、または専用フォルダーを作ります。こうすると過剰共有にまつわる問題を抑えられ、ユーザーが機微なファイルや無関係なファイルをエージェントの参照範囲にうっかり入れてしまうリスクも減ります。既存のSharePointサイトを使うと決めた場合は、その中身を丁寧に見直し、エージェントに見つけられては困る機密情報や機微な情報が置かれていないことを確かめてください。
アクセス権の付与
対象となるユーザー全員が、そのサイトやフォルダーに必要な読み取り権限を持っていることを確かめることも大切です。手作業で権限を与える必要がある場合は、対象ユーザー全員がサイトへの読み取りアクセスを持つようにしてください(たとえばSharePointサイトの閲覧者グループや適切なAzure ADセキュリティグループに追加する)。そのほうが手順が簡単になり、権限の設定ミスも防げます。
ファイルを準備する
Copilot Agentsで使う文書を用意するときは、現時点でAIがファイルに埋め込まれた画像を読み取れないことを念頭に置いてください。そのため、画像には説明的なキャプションや代替テキストを付け、重要な視覚情報が失われないようにします。文字量の多い文書では、内容を要約したり参照したりする際に、Copilotがうまく動くよう合計で150万語または300ページまでに収めてください。
Excelファイルでは、1つのファイルが数値かテキストのどちらかに寄るようにデータを整理してください。数値とテキストが混ざった表は、結果の精度が落ちる傾向があります。また、対象のデータがブック内の1枚のシートに収まっているほうが、エージェントは安定して答えます。
エージェントは、Excelのデータが1枚のシートに収まっているときに最もよく答えます。
例を挙げます。大規模な顧客アンケートの結果が1つのExcelファイルに入っている場合、定量データ(評点や数値回答など)と定性データ(自由記述など)を2つのシートに分けてください。こうすれば、数値データはPythonやExcelの数式で効率よく分析でき(平均の算出、並べ替え、信頼水準の判定など)、テキストの回答はM365 Copilotの感情分析機能で読み解けます。
ファイルの制限
最後に、Copilot AgentsとCopilot Studioがサポートするファイル形式とサイズの上限を把握しておいてください。現在のサポート状況は次の表のとおりです。https://learn.microsoft.com/en-us/microsoft-365-copilot/extensibility/copilot-studio-agent-builder-knowledge#file-size-limits
Microsoftが文書の長さについて示しているベストプラクティスもあわせて確認してください。https://support.microsoft.com/en-gb/topic/keep-it-short-and-sweet-a-guide-on-the-length-of-documents-that-you-provide-to-copilot-66de2ffd-deb2-4f0c-8984-098316104389
| File type | SharePoint Online - Limit | Manual Upload - Limit |
|---|---|---|
.doc | 150 MB | 100 MB |
.docx | 512 MB | 100 MB |
.html | 150 MB | not supported |
.pdf | 512 MB | 100 MB |
.ppt | 150 MB | 100 MB |
.pptx | 512 MB | 100 MB |
.txt | 150 MB | 100 MB |
.xls | 150 MB | 100 MB |
.xlsx | 150 MB | 100 MB |
SharePoint Onlineで現在サポートされていないファイル形式について。公式には、そこに挙がっていないものはすべて正式なサポート対象外です。
CSVのような一部の形式は、プレーンテキストに近いため正式にはサポート外でも十分に機能することがあります。ただし、CAB、EXE、ZIPのようなコンテナ形式や、PNG、IMG、MP3、MP4といった画像・動画・音声の形式をはじめ、その他ほとんどのファイル形式は現時点では対応していません。
おわりに
ここまでの推奨事項に従えば、Copilot Agentsが構造の整った、安全で質の高いデータを使えるようになり、その有用性を最大限に引き出しつつ、うっかりデータを露出させるリスクを最小限にできます。SharePoint環境の準備に時間を投じることが、AIエージェントの展開と定着を成功させる強い土台になります。
実際、当社の「エージェントを作る」プロジェクトの多くは、まさにここから始まります。エージェントを作るのではなく、AIに使わせるデータの質を高めるためにインフラと知識を整えるところからです。エージェントは、その下にあるシステムの出来を超えられないからです。

Agent-Ready Infrastructure:生産的なCopilot Agentsのための土台
AIは、その下で動くインフラの出来を超えられません。Copilot Agentsを実務で本気で使うなら、ライセンスと有効化だけでは足りません。必要なのは、構造化されたデータ、一貫したガバナンス、そしてスケールする練られたアーキテクチャです。ひとことで言えばAgent-Ready Infrastructureです。
英語で行う本セッションでご紹介する内容です。
- データ品質と情報アーキテクチャが成否を分ける理由
- Microsoft 365環境を生産的なエージェントに耐えるものにする方法
- 自社が明日AIから本当に恩恵を受けるために、今日動かすべきつまみ
関連記事

MFA向けSMSの終わり
企業がいまフィッシング耐性のある、できるだけパスワードレスな認証方式へ移行すべき理由。

ClickFix。ユーザー自身がエクスプロイトになるとき、そしてそれを止める方法
ClickFixはユーザーを自分自身への攻撃者に変えます。偽のCAPTCHA、コピー&ペースト、そして悪意あるコードがメモリ上で走り、ディスクには何も残りません。Microsoft Defenderがこの攻撃をどう検知するのか、検知はどこで限界に達するのか、そしてRunMRUハントと4つの防御レイヤーでその隙間をどう埋めるのかを解説します。

管理業務と日常業務を1台のPCで。Game Overです。
CIOにとってテナントが1つでは足りない理由と、2つ目がめったに検討されない理由。Managed Red Tenantは管理業務をオフィス環境からアーキテクチャとして分離し、Managed Dark Tenantは防御が破られてもなお組織が動き続けられるようにします。それが運用モデル、SOCのシグナル、そしてNISG 2026による証明義務にとって何を意味するのかを解説します。

4度のLeader。ISGドイツ調査2026のglueckkanja
ISG Provider Lens®調査2026は、ドイツにおいてglueckkanjaを4つのクアドラントでLeaderに位置づけました。Microsoft Productivity and Business Process ServicesとAzure Managed Servicesの、それぞれLarge MarketとMid Marketです。調査の名称はMicrosoft AI and Cloud Ecosystemに変わり、評価の尺度も移りました。AIとエージェントのワークロードを制御可能なかたちで運用できるかが問われています。

Rising StarからLeaderへ。ISGスイス調査2026のglueckkanja
ISG Provider Lens®調査2026は、スイスにおいてglueckkanjaをMicrosoft AI and Cloud Ecosystemクアドラントの、Azure Managed Services領域とMicrosoft Productivity and Business Process Services領域でLeaderに位置づけました。ベルンでの市場参入から2年、Rising Star選出から1年でのことです。

Outbreak。OpenAI/Hugging Faceの事案が示すこと、示さないこと
AIエージェントがテスト環境から脱出し、ゼロデイを見つけ、別の企業をハッキングする。映画の脚本のようですが、2026年7月に実際に起きました。冷静に位置づける時期です。少しの心理学、2人のセキュリティ専門家、そしてそれが自社の防御にとって何を意味するのかという問いとともに。

LeaderそしてRising Star。ISGサイバーセキュリティ調査2026のglueckkanja
ISG Provider Lens®調査 Cybersecurity 2026は、glueckkanjaをNext-Gen SOC/MDR Services(Midmarket)クアドラントのLeaderに選出しました。Next-Gen SOC/MDR Servicesの全体市場では、当社はRising Starです。ISGは当社の平均を上回る成長、Microsoftセキュリティに関する深い専門性、そしてドイツ国内から提供する24時間365日のSOCを評価しています。

The Holy Trinity:AIが実際に働くために本当に必要なもの
ある製造業の企業が、14,000あるSKUのうちどれが実際に利益を生んでいるのかを知りたいと考えました。答えは3つのシステムの中にありますが、それらは一度もデータを1件たりともやり取りしたことがありません。少し前までは、その答えを得るのに3つの部門、2週間、そして相当な善意が必要でした。2026年初頭からは、AIがこの問いに数分で答えられます。データを走査し、関連を結び、推奨を出す。ただし、アクセスできることが前提です。

契約書にサインしたあと:当社のオンボーディングはこう進みます
契約書にサインが済み、大きな一歩は終わりました。では、ここからどうなるのでしょうか。PreBoardingからチームでの最初の1週間まで、当社のオンボーディングの舞台裏をご案内します。

Microsoft Frontier Partner:当社もその一員です
最近、Microsoft AI Cloud Partner Programに新たな最高位の称号としてFrontier Partner Badgeが設けられました。Microsoftがこれを授与するのは、ワークプレイスからクラウドプラットフォーム、セキュリティ、そしてAIアプリケーションそのものに至るまで、Microsoftスタック全体でAIプロジェクトを確実に届けられると実績で示した、世界でもごく限られたパートナーだけです。DACH圏でこのグループに属するのは数社にすぎず、当社はそのうちの1社です。

チャリティのために160キロ
同僚11人、16周、160キロ、雷雨、そして表彰台。glueckkanjaはFrankfurter Runden 2026に参加し、走った1周ごとにVAIR e.V.へ寄付しました。同団体はオフェンバッハでインクルーシブなスポーツ・カルチャーパークを建設しています。

未知のAMOSスティーラーの解剖:アラートから免疫獲得まで数時間
これまで文書化されていなかったAMOSスティーラーの亜種が、macOSエンドポイントを侵害しました。既知のハッシュはなく、公開データベースにC2データもありません。当社のSOCは6層の難読化を解体し、すべての指標を抽出したうえで、業界がこの検体を目にするよりも前に、数時間以内ですべてのSOCのお客様へ保護を配布しました。

Edgeを唯一の社内標準ブラウザーにすべき理由
Chromeを本気で選んだ企業はほとんどありません。独自の同期ロジック、独自のアカウント管理、独自のポリシー画面を抱えたまま、ただそこにあっただけです。一方でMicrosoft Edgeは、すでに動いているインフラ、つまりEntra ID、Intune、Defenderに直接組み込まれます。本記事では、移行がどのようなものか、IntuneのポリシーでどのようにChromeをランディングページへリダイレクトするか、そして2つのブラウザーを並行運用するのをやめると何が不要になるかを紹介します。

必要だったのは管理者アカウント1つだけでした
2026年3月11日、Handalaは79か国の端末を消去しました。そのために必要だったのは、侵害されたIntuneの管理者アカウント1つだけです。マルウェアもエクスプロイトもなく、正規の管理ツールが所有者自身に向けられました。何が起きたのか、なぜそれが通用したのか、そして塞ぐべき2つのアーキテクチャ上の穴について説明します。

6つのAgent。4週間。実際の運用へ。
6社、4週間のビルドフェーズ、6つの動作するAI Agent。これが第1回glueckkanja AI Agent Hackathonの成果です。Kiekert、Dr. Oetker、Eckes-Granini、igefa、lila logistikがCopilot StudioでAgentを構築し、それらは現在すでに本番で稼働しています。そこで何が生まれ、この形式がどのように機能するのかを紹介します。